오픈AI의 GPT-6 아스트라(Astra)와 앤트로픽의 클로드 페이블(Fable) 5.1, 두 최상위 AI 모델이 나란히 공개되면서 실무진의 관심이 집중되고 있습니다.
특히 코딩과 데이터 분석처럼 AI에게 작업을 통째로 일임하는 ‘에이전트형 워크플로우’에서 두 모델의 성향 차이는 극명하게 갈립니다.
공개된 벤치마크 데이터와 실사용 테스트를 바탕으로 GPT-6 아스트라 vs 클로드 페이블 비교 핵심 포인트를 정리해 드립니다.
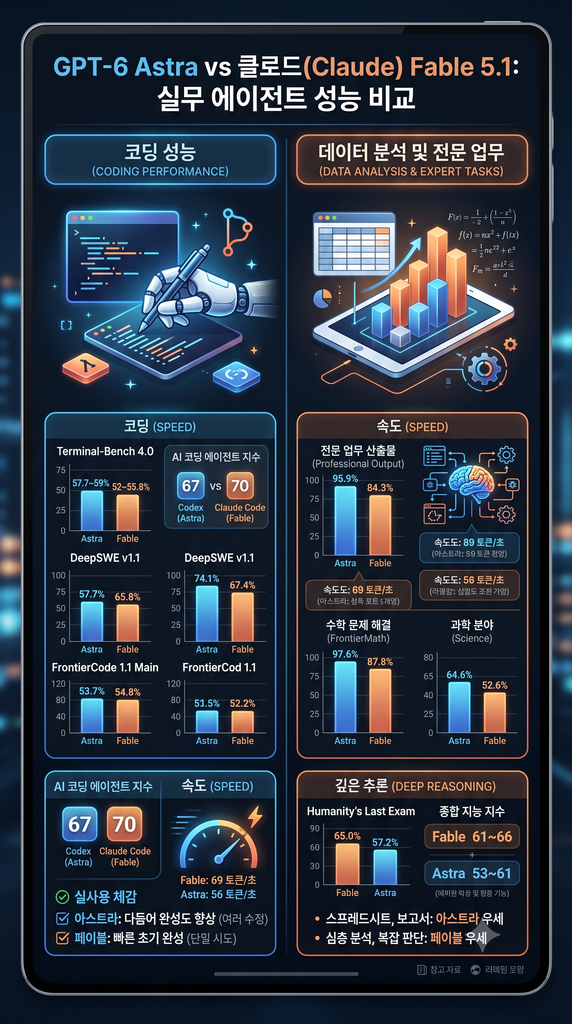
1. 코딩 성능: GPT-6 아스트라 vs 클로드 페이블 비교 결과
코딩 관련 지표는 평가 방식에 따라 결과가 상반되게 나타납니다.
표준화된 자체 성능 테스트에서는 GPT-6 아스트라가 근소하게 앞서는 항목이 많습니다.
| 벤치마크 | GPT-6 아스트라 | 클로드 페이블 5.1 | 우세 모델 |
| Terminal-Bench 4.0 | 57.7~59% | 52~55.8% | 아스트라 |
| DeepSWE v1.1 | 74.1% | 67.4% | 아스트라 |
| FrontierCode 1.1 Main | 53.3% | 50.9% | 아스트라 |
단순 숫자만 보면 아스트라가 우세해 보이지만, 실제 개발 현장의 체감 지표에서는 페이블 5.1이 더 강력합니다.
- AI 코딩 에이전트 지수: 독립 평가기관 아티피셜 애널리시스(Artificial Analysis) 기준, 클로드 코드(페이블)가 70점으로 코덱스(아스트라, 67점)를 앞섰습니다.
- SWE-bench Pro 리더보드: 실제 복잡한 소프트웨어 버그 해결 능력을 재는 평가에서 클로드 페이블 5.1이 81.2%로 1위를 기록했습니다.
즉, 정해진 문제를 빠르게 푸는 테스트는 아스트라가 뛰어나며, 장기적인 복잡 이슈 해결 능력은 페이블이 우위에 있습니다.
2. 데이터 분석 및 전문 업무: 오피스 vs 심층 추론
데이터 분석 및 실무 산출물 제작에서도 두 모델의 특화 영역이 나뉩니다.
슬라이드, 스프레드시트, CAD 도면을 제작하는 전문 업무 벤치마크에서는 아스트라가 95.9%로 페이블 5.1(84.3%)을 크게 따돌렸습니다.
수학(FrontierMath 97.6% vs 87.8%) 및 과학(Terminal-Bench Science 64.6% vs 52.6%) 지표 역시 아스트라가 우수합니다.
따라서 데이터를 정리해 표나 보고서 형태로 추출하는 업무는 아스트라가 훨씬 유리합니다.
반면 복잡한 전제 조건을 검증하는 심층 추론 평가인 ‘Humanity’s Last Exam’에서는 페이블 5.1이 65.0%를 기록해 아스트라(57.2%)를 제쳤습니다.
자료 취합을 넘어 다면적 가설 검증과 데이터 해석이 필요한 작업에는 페이블의 신중함이 돋보입니다.
관련 참고 글:GPT-6 아스트라 ERP 업무 적용 가이드
3. 실전 체감 차이와 작업 완료 방식
물리 시뮬레이션 웹페이지 제작 테스트를 동일하게 요청했을 때, 산출물을 내는 스타일이 완전히 달랐습니다.
- GPT-6 아스트라: 6번의 수정을 거치며 피드백을 반영해 완벽한 UI(5점/5점)를 점진적으로 완성했습니다.
- 클로드 페이블 5.1: 단 1회의 시도만으로 진단용 화면(HUD)이 포함된 완성형 결과물(4점/5점)을 신속하게 제시했습니다.
출력 속도는 페이블이 초당 약 69토큰으로 아스트라(초당 약 56토큰)보다 빠르며, 첫 응답 지연 시간(TTFT)도 더 짧았습니다.
4. 실질 API 작업 비용 비교
두 모델의 정가(입력 100만 토큰당 10달러, 출력 100만 토큰당 50달러)는 동일하지만 실제 작업 형태에 따라 청구 금액이 달라집니다.
- 단발성 작업 실질 비용: 아스트라(약 1.67달러)가 페이블(약 3.76달러)보다 약 2.25배 저렴합니다.
- 프롬프트 캐시 비용: 페이블 5.1이 0.25달러로 아스트라(1.00달러) 대비 4배 저렴합니다.
- 대용량 컨텍스트 (27만 2천 토큰 이상): 아스트라는 추가 할증이 붙는 반면, 페이블 5.1은 할증이 없습니다.
5. 실무 선택 기준 가이드
업무 목적에 맞춰 다음과 같이 선택하는 것을 추천합니다.
- GPT-6 아스트라 추천: 스프레드시트/슬라이드 자동 생성, 단순 반복 작업 대량 처리, OS 화면 조작(AutomationBench 아스트라 41.4% vs 페이블 31.4%).
- 클로드 페이블 5.1 추천: 대규모 코드베이스 유지보수, 장문 문서 기반 심층 분석, 다단계 의사결정이 필요한 복합 엔지니어링.
두 모델 모두 티어별 테스트 환경을 제공하므로, 사내 주력 작업 한두 개를 선별해 실측 테스트를 선행해 보시기 바랍니다.
IT나라(ITNARA) | Odoo ERP/MES 구축 전문 기업 위고솔루션(wegosolution) 공식 IT 지식 블로그
대표: 최성남 | 홈페이지: www.wegosolution.co.kr